Niewidzialni dla AI. Jak sprawdzić, czy serwer nie blokuje wyszukiwarek sztucznej inteligencji
Dostaliśmy maila: „ChatGPT nie zna Państwa firmy”. Sprawdziliśmy — to była prawda, ale z zupełnie innego powodu, niż sugerował nadawca. Serwer odsyłał boty sztucznej inteligencji błędem 429, choć robots.txt je zapraszał. Opisujemy, jak znaleźliśmy przyczynę i jak w kilkanaście minut sprawdzić to samo u siebie.
Takie wiadomości trafiają do skrzynek regularnie. Nadawca twierdzi, że sprawdził widoczność firmy w asystentach AI, wynik wypadł źle, i proponuje bezpłatny audyt wraz z „gotowymi materiałami eksperckimi". Zwykle kończą w koszu.
Tym razem zweryfikowaliśmy samo twierdzenie. Okazało się trafne — choć przyczyna leżała zupełnie gdzie indziej, niż sugerował nadawca, i żadna usługa content marketingowa by jej nie usunęła. Poniżej opisujemy, jak ją znaleźliśmy, i pokazujemy, jak przeprowadzić to samo sprawdzenie u siebie.
Nowy kanał dotarcia, stare założenia
Coraz więcej osób nie wpisuje pytań w wyszukiwarkę, tylko zadaje je asystentowi. „Kto robi audyty dostępności cyfrowej?", „jaka firma przeszkoli zespół z WCAG?" — odpowiedź przychodzi w formie gotowej rekomendacji z dwoma, trzema nazwami. Jeśli nie ma w niej Twojej organizacji, nie trafisz na listę do rozważenia.
Żeby asystent mógł wymienić Twoją stronę, musi ją wcześniej przeczytać. Robią to programy zwane crawlerami albo botami — osobne dla każdego dostawcy. OpenAI używa GPTBot i OAI-SearchBot, Anthropic ClaudeBot, Perplexity PerplexityBot, Apple Applebot. Każdy z nich odwiedza stronę tak jak przeglądarka i zapisuje to, co zobaczy.
Muszą być spełnione dwa warunki — i tu zaczyna się problem, bo większość poradników wspomina tylko o pierwszym.
Pozwolenie to nie to samo co dostęp
Pierwszy warunek to pozwolenie. Plik robots.txt w katalogu głównym strony mówi botom, czego im wolno. To jednak tylko deklaracja — grzeczna prośba, którą porządne boty respektują.
Drugi warunek to faktyczny dostęp. Nawet jeśli robots.txt zaprasza, serwer może odmówić obsługi. Dzieje się to warstwę niżej, zanim strona w ogóle się uruchomi, i wygląda jak zwykły błąd:
- 403 Forbidden — serwer rozpoznał bota i odmówił
- 429 Too Many Requests — bot przekroczył limit liczby żądań
- 503 Service Unavailable — usługa chwilowo niedostępna
- CAPTCHA albo strona weryfikacji — bot dostaje formularz zamiast treści
Te dwie warstwy bywają ze sobą sprzeczne i nikt Cię o tym nie poinformuje. W panelu analitycznym nie pojawi się ostrzeżenie. Narzędzia SEO tego nie wykryją, bo sprawdzają stronę, podając się za przeglądarkę. Dowiesz się dopiero wtedy, gdy ktoś zapyta asystenta o Twoją branżę i usłyszy nazwy konkurencji.
Jak to wyglądało u nas
Zaczęliśmy od sprawdzenia tego, co zwykle bywa przyczyną. Nasz serwis był pod tym względem przygotowany lepiej niż typowa strona firmowa:
robots.txtz jawną listą 24 botów AI i pełnym pozwoleniem dla każdego z nich- pliki
llms.txtillms-full.txt— opis firmy i oferty przygotowany specjalnie dla modeli językowych, po polsku i po angielsku - dane strukturalne schema.org: typ
OrganizationiProfessionalService, z numerami KRS, NIP i REGON oraz polemknowsAboutwymieniającym wprost audyty dostępności, WCAG 2.1 i 2.2, EN 301 549 i European Accessibility Act - mapa strony z ponad 500 adresami
Innymi słowy: wszystko, co zwykle się doradza, było już zrobione. A mimo to strona nie pojawiała się w odpowiedziach asystentów.
Test, który wszystko wyjaśnił
Postanowiliśmy odwiedzić własną stronę tak, jak robi to bot. Wystarczy jedno polecenie, które pobiera stronę, podając się za konkretny program — tutaj za bota OpenAI:
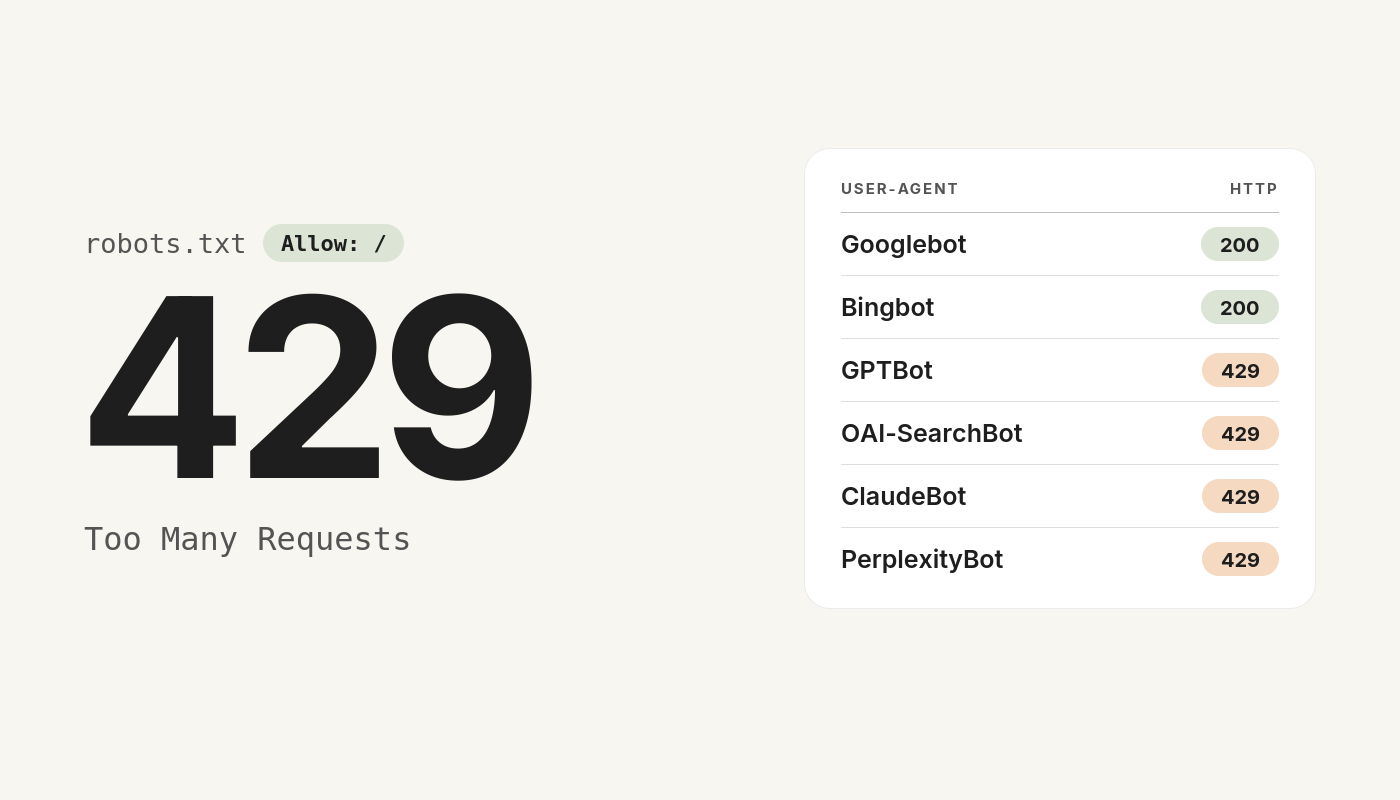
curl -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.2; +https://openai.com/gptbot" -I https://twojadomena.pl/Wynik był jednoznaczny. Te same adresy, odpytane w tym samym momencie, różnymi programami:
| Kto odwiedza stronę | Odpowiedź serwera |
|---|---|
| Przeglądarka internetowa | 200 — pełna strona, 113 kB |
| Googlebot | 200 — pełna strona |
| Bingbot | 200 — pełna strona |
| GPTBot (OpenAI) | 429 — 17 bajtów błędu |
| OAI-SearchBot (wyszukiwarka ChatGPT) | 429 |
| ClaudeBot (Anthropic) | 429 |
| PerplexityBot | 429 |
| Applebot, Amazonbot, Meta, YandexBot | 429 |
| Zmyślony, nieistniejący bot | 200 — pełna strona |
Ostatni wiersz jest najciekawszy. Wymyślona nazwa przechodziła bez przeszkód, a nazwani crawlerzy AI dostawali błąd. To nie był więc żaden limit obciążenia — to była lista nazw.
Jeden szczegół okazał się wyjątkowo przewrotny: plik robots.txt ładował się poprawnie. Bot czytał więc uprzejme zaproszenie „wchodź, wszystko wolno", po czym dostawał błąd na każdej realnej podstronie. Z jego perspektywy strona istniała, ale była pusta.
Skąd się bierze błąd 429
Przyczyną był mechanizm rate limitingu — ograniczania liczby żądań — działającego na poziomie serwera, w module ModSecurity. Hostingi włączają go domyślnie i mają po temu dobry powód: crawlery potrafią generować ogromny ruch, a na serwerze współdzielonym jeden intensywny bot spowalnia wszystkich.
Problem w tym, że domyślna lista obejmuje bez rozróżnienia zarówno boty, które tylko zużywają zasoby, jak i te, które są dziś kanałem dotarcia do klienta. Googlebot i Bingbot bywają z niej wyłączone jako zweryfikowane — reszta wpada do jednego worka.
Warto podkreślić: to nie jest wina ani błąd hostingu. To rozsądne ustawienie domyślne, ustanowione zanim asystenci AI stali się kanałem sprzedaży. Trzeba je tylko świadomie dostosować.
Jak sprawdzić to u siebie
Potrzebne jest narzędzie curl, dostępne standardowo w Windowsie, macOS i Linuksie. Otwórz terminal (w Windowsie: PowerShell) i wklej poniższe polecenia, podmieniając adres na własny.
Krok 1. Punkt odniesienia — zwykła przeglądarka.
curl -o nul -s -w "%{http_code}\n" https://twojadomena.pl/Powinno pokazać 200. Jeśli nie — problem jest większy i dotyczy wszystkich odwiedzających.
Krok 2. To samo, ale jako bot OpenAI.
curl -A "GPTBot/1.2 (+https://openai.com/gptbot)" -o nul -s -w "%{http_code}\n" https://twojadomena.pl/Krok 3. Pozostali crawlerzy. Powtórz krok 2, podmieniając nazwę po -A na kolejne: OAI-SearchBot, ClaudeBot, PerplexityBot, Applebot, meta-externalagent.
Jak czytać wynik:
- 200 — w porządku, bot dostaje stronę
- 403 — serwer blokuje bota wprost
- 429 — bot wpada w limit liczby żądań
- 503 — usługa niedostępna, często też forma blokady
- 301 lub 302 — przekierowanie, sprawdź dokąd prowadzi
Krok 4. Sprawdź, czy limit nie wraca. Jedno udane żądanie to za mało — rate limiting z definicji uruchamia się dopiero po kilku. Pobierz pod rząd kilkanaście różnych podstron jako ten sam bot i sprawdź, czy wszystkie zwracają 200. Realny crawler odwiedza setki adresów.
Krok 5. Porównaj treść. Zdarza się, że bot dostaje kod 200, ale uboższą wersję strony. Zapisz obie wersje do plików i porównaj ich rozmiar — powinny być zbliżone.
Gdzie szukać ustawienia
Na hostingach współdzielonych z panelem DirectAdmin bywa osobna sekcja poświęcona botom AI, a w niej trzy warstwy, które łatwo pomylić:
- Kontrola botów AI — czy bot ma w ogóle wstęp
- Ustawienia robots.txt — co deklarujemy botom
- Rate Limiting (ModSecurity) — ile żądań bot może wykonać
U nas dwie pierwsze były ustawione poprawnie, a cała przyczyna leżała w trzeciej. Jeśli w Twoim panelu nie ma takiej sekcji, napisz do hostingu — podaj konkretne nazwy botów i wynik testu curl. To znacznie przyspiesza zgłoszenie.
Których botów wpuścić, a których nie
Nie zalecamy wyłączania ochrony dla wszystkich. Sensowny podział wygląda tak:
| Bot | Decyzja | Dlaczego |
|---|---|---|
| OAI-SearchBot, GPTBot | wpuścić | wyszukiwarka i baza wiedzy ChatGPT |
| ClaudeBot, PerplexityBot | wpuścić | kolejni asystenci z rosnącym udziałem |
| Applebot | wpuścić | Siri i wyszukiwanie Apple |
| meta-externalagent | wpuścić | Meta AI |
| facebookexternalhit | wpuścić | to nie jest bot AI — pobiera podgląd linku na Facebooku, Messengerze i WhatsAppie. Z włączonym limitem zamiast miniatury i tytułu widać goły adres |
| AhrefsBot, SemrushBot, MJ12bot | ograniczyć | crawlery narzędzi SEO — generują duży ruch, nie dają widoczności, a zbierają dane o Twojej stronie dla konkurencji |
| Fałszywy bingbot | ograniczyć | reguły tego typu dotyczą żądań podszywających się pod Bingbota z adresów spoza puli Microsoftu — prawdziwego bota nie obejmują |
Czego ta zmiana nie załatwi
Po poprawieniu ustawień powtórzyliśmy cały test: wszystkie boty AI otrzymały pełną stronę, kilkanaście żądań pod rząd przeszło bez błędu, a treść okazała się identyczna z tą, którą widzi przeglądarka. Crawlery SEO pozostały ograniczone, zgodnie z zamierzeniem.
Trzeba jednak pamiętać o dwóch rzeczach.
Zmiana nie działa wstecz. Asystenci muszą odwiedzić stronę ponownie, a to trwa — zwykle od kilku dni do kilku tygodni, zależnie od crawlera. Sam fakt usunięcia blokady widać natychmiast, efekt w odpowiedziach modeli dopiero po ponownym zaindeksowaniu.
Dostępność techniczna to warunek konieczny, nie wystarczający. Asystent, który może przeczytać stronę, nadal musi uznać ją za wartą zacytowania. Liczy się jasny opis usług, konkretne dane firmy, wartościowe treści i wzmianki w innych źródłach. Ale żadna z tych rzeczy nie zadziała, jeśli crawler dostaje komunikat o błędzie.
I to jest puenta całej historii. Gdybyśmy kupili „materiały eksperckie" oferowane w tamtym mailu, problem pozostałby dokładnie taki sam. Nie brakowało treści — brakowało możliwości jej przeczytania.
Lista kontrolna
- Sprawdź
curl-em, jaki kod odpowiedzi dostają GPTBot, OAI-SearchBot, ClaudeBot i PerplexityBot - Powtórz test na kilkunastu podstronach pod rząd, żeby wykluczyć limit liczby żądań
- Porównaj rozmiar strony otrzymanej przez bota i przez przeglądarkę
- Zajrzyj do panelu hostingu w sekcję rate limitingu i sprawdź, które boty są ograniczone
- Zweryfikuj, czy
robots.txtrzeczywiście zezwala botom, na których Ci zależy - Upewnij się, że
facebookexternalhitnie jest ograniczony, jeśli udostępniacie linki w mediach społecznościowych - Powtórz całe sprawdzenie po każdej zmianie hostingu, przejściu na nowy serwer lub włączeniu CDN-u albo nowej ochrony przed botami
Całość zajmuje kilkanaście minut, a potrafi wyjaśnić nieobecność, której nie widać w żadnej statystyce.